寫數學講義時,附解答的練習題最好用:做完就能對答案,錯了馬上知道錯在哪,下次就不會再錯。可是如果解答本弄丟了,你還學得到東西嗎?
這個問題,就是機器學習分成好幾種學習方式的原因。初級科目一「人工智慧基礎概論」很愛考這件事:官網公布的 4 份初級科目一試題(114 年第四次、115 年第一次到第三次,共 200 題)裡,有 20 題在考監督式、非監督式、半監督式和強化式學習怎麼分,大約每 10 題就有 1 題。
題目每次都換一個情境,有時是銀行抓洗錢,有時是農場辨識病害。這篇跟著一個問題走:考題換了情境,怎麼判斷它用的是哪一種學習? 我們從「有沒有解答」出發,一步一步推出四種學習方式。
有解答和沒解答:監督式與非監督式
先看有解答的情況。假設銀行有過去 5 年的交易紀錄,每一筆都已經標好「正常」或「洗錢」。模型看著這些資料,學會「什麼樣的交易對應到什麼答案」,之後遇到新交易,就能判斷它比較像哪一種。
這就是監督式學習:每筆訓練資料都附了答案,這個答案叫做「標籤」。答案是類別(正常/洗錢)時叫分類;答案是一個數字(下一季的稻米產量是幾公噸)時叫迴歸。
那解答本弄丟了呢?你還是可以做一件事:把題目分類。翻一翻講義,你會發現這幾題都在算三角形面積、那幾題都在解方程式,雖然不知道答案,題目自己會分成幾堆。
這就是非監督式學習:資料沒有標籤,模型只能從資料本身找結構,例如把行為相似的會員分成幾群。要注意,分出來的每一群代表什麼意思,模型不會告訴你,要由人來解讀。所以非監督式學習可以把資料分群、找出結構,卻不能在沒有標籤的情況下,準確判斷每一筆屬於哪一個事先定義好的類別。
講義這個比喻有一個地方不像:講義的解答是現成的,真實資料的標籤卻要有人一筆一筆標上去。5 年的交易紀錄,要請專人逐筆確認是不是洗錢,很花時間也很花錢。這一點等一下會很重要。
用一次:同一家公司,兩種資料
現在換一個情境試試看。某電商有兩批會員資料:一批已經標好「這位會員後來有沒有流失」,另一批只有瀏覽、消費和搜尋紀錄,沒有任何結果。這兩批資料各適合哪一種學習?
先別往下看,用上一段學到的規則判斷。
有標好流失結果的那一批,附了答案,適合監督式學習,用來預測新會員會不會流失。只有行為紀錄的那一批,沒有答案,適合非監督式學習,用來找出有哪幾種消費族群。同一家公司可以兩種都用,判斷的依據不是公司或產業,而是那批資料附了什麼。
只有一部分有解答:半監督式學習
回到剛才說「很重要」的那一點:標籤很貴。所以真實世界最常見的情況,其實是只有一小部分資料有標籤。
假設一家食品加工廠收集了 10,000 張水果照片,只有 2,000 張請人標好「正常、碰傷、病斑」,其餘 8,000 張沒有標註。只用 2,000 張訓練,等於把八成的資料丟掉;全部重新請人標,又太貴。
這時用的是半監督式學習:先用有標籤的那一小部分學出分類方式,再從大量沒有標籤的資料裡學習整體的分布,讓模型表現更好。就像講義只有一部分題目附解答,你先把有解答的做熟,再用同樣的方法去推敲其他題目。
這是初級最常見的陷阱之一。題目寫「同時使用少量已標註資料與大量未標註資料」,選項卻說這是監督式學習,那就是錯的。只要「有一部分沒有標籤」,就要想到半監督式。
沒有解答,但做完會得分:強化式學習
還有一種情況,前面三種都套不上。想想你第一次學騎腳踏車:沒有人給你一本「每個瞬間該怎麼轉龍頭」的解答,你只知道騎得穩就繼續、摔倒了就換個方式,慢慢就會了。
這就是強化式學習:沒有標準答案,模型(通常叫做「代理人」)在環境裡做出動作,得到獎勵或懲罰,再依結果調整自己的做法,這套做法叫做策略。物流公司規劃配送路線、自駕車在模擬環境裡學過路口、投資系統依每次交易的盈虧調整買賣,都是官方試題出現過的強化式學習情境。
強化式學習有一個特有的難題,叫做探索與利用的權衡。你每天午餐都去同一家便當店,因為確定好吃,這是利用;偶爾試一家新開的店,可能踩雷,也可能發現更好吃的,這是探索。推薦系統如果只推過去賣得好的商品,就永遠不知道新商品會不會更好賣。
腳踏車的比喻也有不像的地方:摔倒是馬上發生的,真實任務的獎勵常常很晚才來。一條配送路線好不好,可能要整天跑完才知道,模型得自己想辦法判斷,是前面哪一步讓結果變好或變差。
這裡也有一個常見陷阱。監督式學習也會計算「錯了多少」,所以有些選項把「依錯誤造成的損失持續調整策略」說成監督式學習。差別在於:監督式學習知道每一筆的標準答案;強化式學習只知道這次做得好不好,不知道正確的動作是什麼。
四種放在一起:先問資料附了什麼
從講義的解答本一路走到這裡,四種學習方式其實是同一個問題的四種答案:
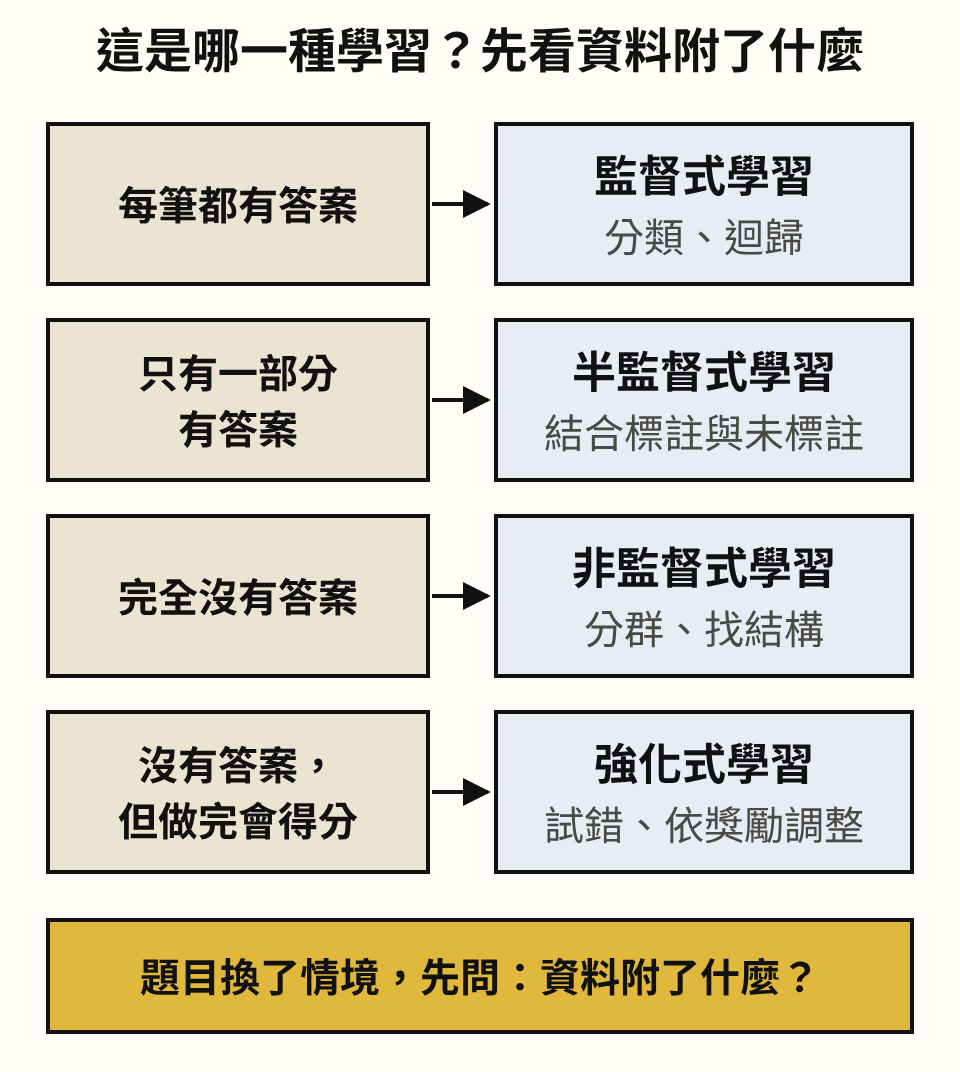
官方試題常把錯誤藏在選項的搭配裡。整理這 20 題選項中出現過的寫法:
| 選項的寫法(都是錯的) | 錯在哪裡 |
|---|---|
| 少量已標註+大量未標註,屬於監督式 | 有一部分沒有標籤,是半監督式 |
| 依回饋或損失持續調整策略,屬於監督式 | 只有好壞回饋、沒有標準答案,是強化式 |
| 非監督式能準確判斷每筆屬於哪一類異常 | 沒有標籤只能分群,群的意義要人判斷 |
| 非監督式需要先定義每筆的正確輸出 | 先定義正確輸出就是標籤,那是監督式 |
| 預測連續數值,用準確率評估 | 這是迴歸,常用平均絕對誤差(MAE) |
接到生成式 AI:同一套想法再用一次
這四種學習方式,到了初級科目二「生成式 AI 應用與規劃」還會再出現,只是換了名字。
大型語言模型的預訓練,用的是大量沒有人工標註的文字。做法是把一句話的下一個字遮起來,讓模型猜,猜完再對照原文。答案不是人標的,而是從資料本身來的,所以常被歸為自監督學習。
模型會說話之後,還要讓它的回答更符合人的偏好。做法是請人比較模型的幾個回答、評出哪個比較好,用這些評比訓練一個會打分數的「獎勵模型」,再用強化式學習讓模型朝高分的方向調整。這就是 RLHF(人類回饋強化學習)。你會發現,它正是上一段「沒有標準答案,但做完會得分」的那一種。
所以下次在科目二看到 RLHF,先別被英文縮寫嚇到。問同一個問題就好:這一步的資料附了什麼?
讀完試試看
某醫院有 10,000 張胸腔 X 光片,其中 600 張有醫師標註「有肺炎」或「沒有肺炎」,其餘都沒有標註。醫院另外想讓排班系統依每週護理人員的滿意度回饋,逐步調整排班方式。這兩件事,各適合哪一種學習方式?
想好再往下看。參考答案:X 光片是半監督式學習,因為只有一部分有標籤,可以先用 600 張有標註的學出判斷方式,再用其餘 9,400 張改善模型。排班系統是強化式學習,因為沒有「正確的班表」可以對答案,只有每週的滿意度當作獎勵,系統依獎勵調整排班策略。
本文的試題統計,是作者以程式從官網公布的 4 份初級科目一公告試題(114 年第四次、115 年第一次至第三次,共 200 題)找出提到監督式、非監督式、半監督式或強化式學習的題目,再逐題確認是否在考這幾種學習方式的區分或特徵;表格中的陷阱改寫自這些題目的選項,不是原題。學習方式的範圍依官方 115 年 6 月版評鑑內容範圍(科目一「常見的機器學習模型」)。本文為個人自學整理,非 iPAS 官方教材;正式評鑑範圍與考試規則,請以 AI 應用規劃師官方專區公告為準。