準備中級科目二「大數據處理分析與應用」時,前一章還在讀平均數、中位數與 p 值,下一章就出現 Kafka、資料湖、PCA 和 Python。如果只照名詞逐一背,很難看出它們為什麼會放在同一科。
我會先把這些內容放回一個資料處理的情境:公司收到資料後,要確認內容是否可靠、整理成能使用的格式,再選擇分析方法,最後把結果用在報表或 AI 系統。不同章節處理的是這個過程裡的不同問題。知道題目正在問哪一步,才比較容易判斷工具與方法是否合適。
先把科目二拆成四層
科目二的評鑑主題包括「機率統計基礎」、「大數據處理技術」、「大數據分析方法與工具」及「大數據在人工智慧之應用」。讀書時,我會用「理解資料、處理資料、分析資料、應用資料」來串起這四個主題,作為整理筆記的方式。正式範圍請以 AI 應用規劃師官方專區 的最新公告為準。
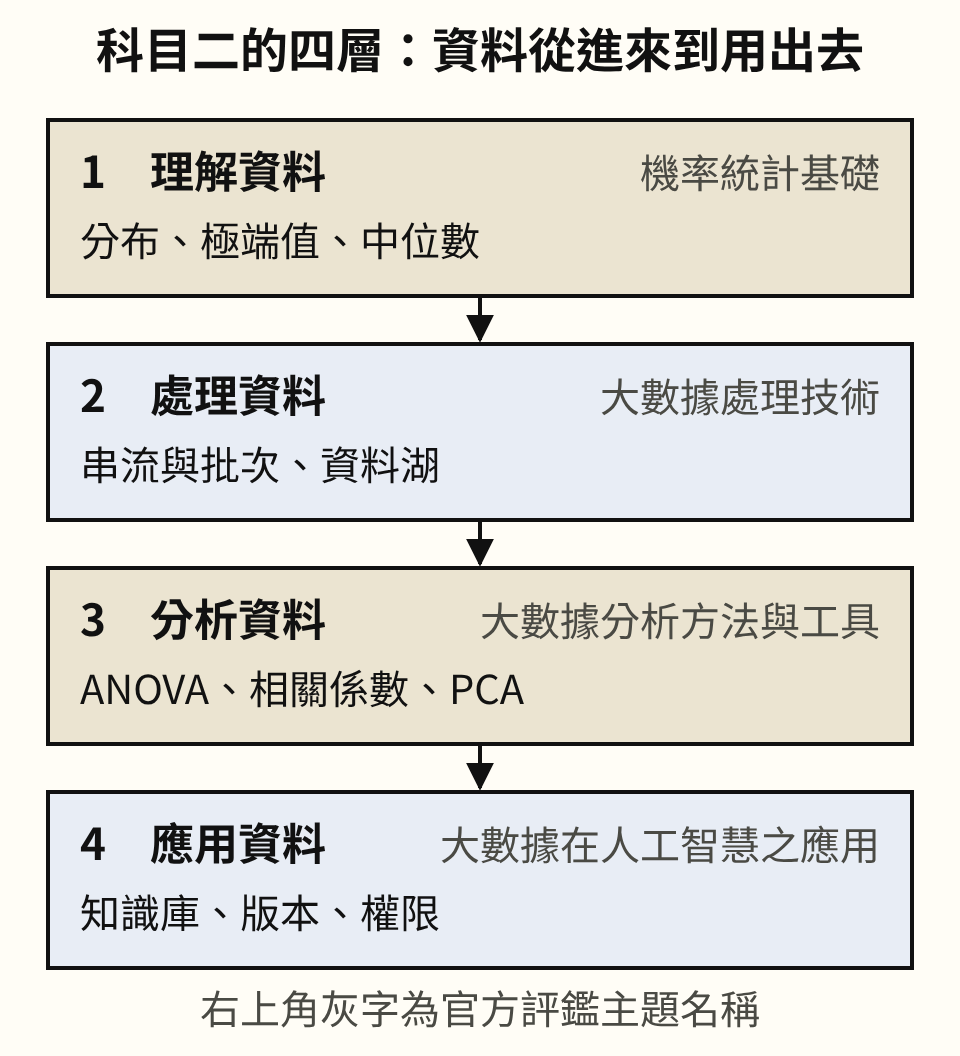
下面用假設情境示範如何辨認問題。表中的數字只用來說明判斷方法,不是官方試題或實際統計。
| 題目描述的問題 | 要先判斷什麼 | 可對照的概念 |
|---|---|---|
| 少數極端值把平均數拉高 | 想描述整體平均,還是典型水準? | 中位數、偏態、離群值 |
| 每秒都有新事件,需要及時處理 | 結果能否等到下一批資料再一起算? | 串流處理、Kafka、Flink |
| 資料格式很多,結構尚未固定 | 如何保留原始資料,並管理格式與存取權限? | Data Lake、Lakehouse、資料治理 |
| 300 個欄位彼此高度相關 | 能否用較少的維度保留主要變異? | PCA、降維 |
| 詐欺樣本只占 0.5% | 只看答對比例,會不會掩蓋漏掉的詐欺? | Recall、F1、PR-AUC |
| 多家醫院不能集中原始病歷 | 能否在資料留在各院的前提下協作訓練? | 聯邦學習、隱私保護 |
這張表的用途是幫你定位問題。選擇方法時,仍要往下看資料型態、時間要求和風險限制,不能看到一個關鍵字就決定答案。
第一層:先搞懂資料長什麼樣
統計方法取決於你想從資料知道什麼。拿到一份資料時,先分辨欄位是數值還是類別,再看數值分布是否偏斜、是否有極端值,接著才選摘要指標或分析方法。
假設一組收入資料中,大部分人的收入接近,只有少數人特別高。計算平均數時,所有金額都會加進去,因此少數高收入會把結果拉高。中位數看的是排序後的中間位置,較不受極端金額影響;如果問題要描述典型收入,它通常比較合適。如果問題要估算總收入或人均金額,平均數仍有用途。
同樣的判斷也能用在房價、訂單金額或醫療費用。讀題時先確認要描述的是什麼,才能說明為什麼選中位數,或為什麼仍需要平均數。
第二層:資料怎麼進來、怎麼存
資料處理工具的選擇,和結果需要多快產生有關。假設一家物流公司持續收到車輛位置與冷鏈溫度,要求在 30 秒內發現異常並通知人員,等到隔天彙整報表就來不及。這類需求適合用串流處理,讓新事件進來後持續接受判斷。
在這個流程裡,Kafka 可以負責傳遞與保留事件,Flink 或 Spark 的串流處理功能則可接著計算、比對條件。工具各有分工,不能把它們當成同一種功能的不同名稱。
如果需求改成每天凌晨彙整前一天的訂單,結果不必逐秒更新,就可以安排批次處理。Airflow 這類工作流程工具能協調任務的時間與先後關係,實際清理和計算仍由各任務執行。比較這兩個情境時,重點在於資料何時到、結果何時要用,以及每項工具負責哪一步。
第三層:分析方法要對應到問題
PCA、相關係數、假設檢定和關聯規則各自回答不同問題。把它們放在一起背,容易只記得名稱;先說出分析目的,再找方法,兩者的關係會清楚得多。
例如,比較 3 組平均數時,可以考慮 ANOVA,但還要檢查獨立性、分布與變異數等假設。想了解兩個數值變數的線性關係,可以看 Pearson 相關係數;資料是等級,或關心的是單調關係時,則可考慮 Spearman。若要找出尿布和濕紙巾是否常在同一筆交易中出現,才會轉向關聯規則。
這些是選擇方法的起點。做題時還要說得出:題目的資料和條件,是否支持使用這個方法。
第四層:把分析結果用進 AI,還要顧資料治理
當公司想用 PDF、客服紀錄和產品資料建立知識庫,模型需要先取得與問題有關的內容,才有依據回答。這時除了選模型,還要處理文件如何切分、版本如何更新、答案如何標示來源,以及誰有權讀取哪些資料。
假設同一份產品說明有新舊兩版,系統若取到舊版,即使模型能流暢回答,內容仍可能過時。若沒有檢查存取權限,回答也可能帶出提問者原本無權查看的資料。這就是資料治理和 AI 應用相連的地方:資料整理與權限設計,會直接影響系統能否提供可靠、適當的內容。
Python 題先從資料的變化讀起
閱讀程式片段時,我會先找它對哪份資料做了什麼,再確認結果長什麼樣。以下以 pandas 資料表為例,假設 df 中每列是一筆訂單,region 是地區,sales 是該筆訂單的銷售額:
df.groupby("region")["sales"].mean()
groupby("region") 先依地區分組,["sales"] 指定要計算的欄位,最後的 mean() 再算出各組平均值。因此,這段程式得到的是每個地區的平均訂單銷售額。若選項寫成總銷售額或訂單筆數,就和最後的計算動作不符。
把每一步接起來看,才知道函式在這段程式裡的用途。更完整的拆解可接著看 Python 題的閱讀方法。
可以先練哪些 Python 操作
以下是整理練習內容時可以採用的順序,不代表官方公布的出題頻率:
- 檢查缺失值:用
isna().sum()查看各欄有多少缺失值,再判斷該補值或移除資料。 - 整理資料:比較
fillna()、dropna()和astype("Int64")的作用,留意缺失值與資料型態。 - 選取與摘要:用
loc[]篩選符合條件的資料,再讀groupby()如何分組計算。 - 轉換表格與分析:分辨
pivot_table()、melt()的輸出形狀,以及corr()計算的關係。
每次練習都試著寫出輸入、處理步驟和輸出。如果只能說出函式名稱,卻不知道資料如何改變,就回到小範例逐步核對。
做題時容易忽略的四個條件
這四個條件分別落在前面四層的不同位置:第 1、3 點屬於分析資料,第 2 點發生在處理資料與分析之間,第 4 點則是理解資料時就該先確認的欄位性質。做錯題時,先想錯在哪一層,比較容易找到要回頭補的章節。
1. 類別比例會影響 accuracy 的意義
假設詐欺只占全部樣本的 0.5%,模型全部猜正常,accuracy 仍可達到 99.5%,但一件詐欺都沒有找出來。評估時要再看漏掉多少詐欺、誤報多少正常案例,依需求選用 Recall、Precision、F1 或 PR-AUC,不能只憑單一數字判斷模型好壞。
2. 前處理也可能用到測試資訊
標準化、Target Encoding 或 SMOTE 若在切分前就使用全部資料,測試資訊可能提前影響訓練。即使已保留最終測試集,交叉驗證內部也要檢查相同問題。可以用資料洩漏與前處理順序中的例子,逐步確認每次學參數或產生樣本時用了哪些資料。
3. p 值需要連同虛無假設解讀
p 值描述的是:在虛無假設及檢定假設成立時,出現目前這麼極端或更極端結果的機率。p 值小,表示這份資料與虛無假設較不相容;它不代表模型答對的機率,也不能直接換算成某個結論為真的機率。
4. 類別編號未必代表大小
假設把台北、台中、高雄編成 1、2、3,這些數字只是代號,原本沒有大小關係。若後續模型把它們當成連續數值,就可能引入不合理的順序或距離。應先確認模型如何使用編碼,再選擇適合的類別處理方式。
如果你只剩兩週
若已經讀過一輪,只剩兩週複習,可以先依上述四個主題整理架構,找出還無法說明用途的概念,再用題目檢查。這個安排的前提是已有基礎;從零開始時,仍要依自己的進度調整。
第一週可以集中處理章節間的關係,例如資料如何進來、為什麼需要清理、分析方法回答什麼問題。第二週做題時,每錯一題就寫下判斷出錯的位置,以及容易混淆的兩個概念。例如 Pearson 與 Spearman、Target Encoding 與 Label Encoding,都要補上各自適用的條件。
回到開頭那些看似分散的名詞,目標是能把它們放回資料流程,說明這一步要解決什麼問題。考前翻筆記時,也就能依自己的缺口複習,不必把所有內容重新抄過一次。
讀完試試看
某醫院想即時偵測加護病房的異常心跳,一有異常就通知護理站。這個需求主要落在哪一層?
想好再往下看。參考答案:主要是第二層「處理資料」。重點在於事件持續進來、必須馬上判斷,適合串流處理;等不到隔天的批次報表。如果題目接著問「用什麼指標確認警報有沒有漏報」,才進到第三層,要看 Recall。
本站整理的是自學方法與理解方式,例子均為教學情境,非 iPAS 官方試題或教材。正式科目名稱、報考方式、評鑑範圍與最新規則,請以官方最新公告為準。