每次新聞公布平均薪資,留言區常有人說自己「被平均」了:報導裡的平均數,比身邊多數人領的還高。這不是數字算錯,而是平均數本來就會被少數高薪拉高。數字沒錯、讀法錯了,正是機率統計題最常考的地方。
準備中級科目二的「機率統計基礎」時,平均數、標準差、p 值、信賴區間這些名詞大多在別的地方看過。真正讓人失分的,常常不是忘記定義,而是題目換了一個情境之後,不確定該用哪個量數,或把結果解讀過頭,例如把 p 值當成「假設為真的機率」。
這篇把我整理的 10 道模擬題情境,依觀念分成六組,每組說明題目在問什麼、怎麼判斷,以及最常見的陷阱。題目情境與數字為自編練習,用來說明判斷方法,不是官方試題。
這六組可以分成前後兩半。前三組在描述手上的資料:中心在哪裡、散得多開、某個數值落在什麼位置。後三組在用樣本推論母體:樣本平均會怎麼變動、看到的差異是不是巧合、估計的範圍有多可靠。前半是後半的基礎,後半的檢定和區間,都會用到前半的平均數、標準差和 Z 值。
六組都在回答同一個問題:看到一個統計數字時,它說了什麼、沒說什麼? 每一組都會先從一個生活裡常見的數字講起,例如薪資、會考 PR 值、民調,再換成考題的情境。
一、集中趨勢:先看資料有沒有被少數極端值拉走
「被平均」的感覺,換成考題就是下面這種情境。
假設一份房屋成交資料有 1,200 筆,九成落在每坪 80~160 萬元,但有 12 筆豪宅交易達到每坪 450~600 萬元。如果要回答「一般民眾普遍的成交水準」,該用哪個統計量?
平均數會把每一筆金額都加進去,所以少數豪宅會把結果明顯拉高。中位數看的是排序後的中間位置,那 12 筆豪宅只是排在最後面,幾乎不會移動中間那一筆,因此較不受極端值影響,比較能代表多數交易。全距只描述資料散得多開,不是中心位置;眾數在這種連續數值資料裡,未必有穩定的代表性。
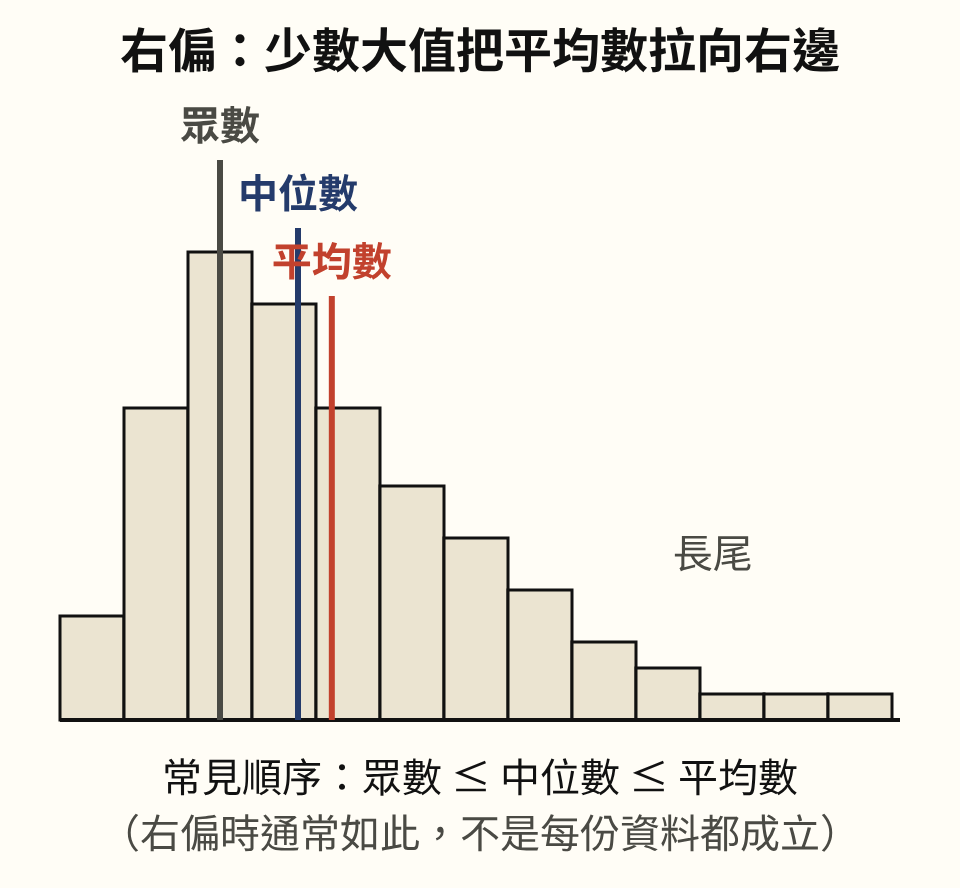
同樣的道理延伸到分布形狀。薪資資料常見大多數人集中在中低區間,少數高階主管把分布往右拉出一條長尾,這叫右偏(正偏態)。長尾那一側的極大值會把平均數拉向右邊,所以通常會看到「眾數 ≤ 中位數 ≤ 平均數」。要注意這是右偏分布的常見情況,不是每份資料都必定成立;而且「偏態」描述的是往哪邊歪,「峰度」描述的是尾端厚不厚,兩者是不同的指標,題目若把它們混在一起,就是錯誤選項。
二、分散程度:比較穩定性時,注意單位與尺度
買零食時,兩個牌子標示的重量一樣,但一個每包都差不多,另一個有時多、有時少,你會覺得前者比較可靠。平均一樣,不代表一樣穩定;「穩不穩」要另外量。
一間工廠量測零件直徑,平均值很接近規格中心,但不同班別量出來的數值分散程度差很多。這時題目要你評估的是「分散程度」與「製程能力」,平均數與中位數都只描述中心位置,回答不了這個問題。
標準差衡量每筆量測值離平均有多遠,數值愈小代表愈集中。工廠進一步會用製程能力指數 Cp = (規格上限 − 規格下限) ÷ (6 × 標準差),比較「規格允許的寬度」和「製程實際的分散程度」。全距只看最大與最小兩個值,容易被單一異常值影響,忽略了中間的分布。
如果要比較兩款產品哪一款比較穩定,但兩者的尺度差很多,例如 A 款平均 200 公克、標準差 4 公克,B 款平均 20 公克、標準差 1 公克,直接比較標準差會被尺度誤導。這時要用變異係數(標準差 ÷ 平均數):A 款是 2%,B 款是 5%,所以 A 款的相對變異較小、較穩定。變異數的單位是公克平方,同樣會受尺度影響,不適合跨尺度比較。
三、常態分布與 Z 值:把分數換算成相對位置
國中會考的 PR 值,告訴你贏過多少百分比的考生。考 80 分算不算好,要看大家考幾分;PR 值把分數換成「在人群裡的位置」。Z 值做的是類似的事,只是換算方式不同:PR 值直接數人數,Z 值先算「比平均高幾個標準差」,再透過常態分布換成百分比,所以資料要接近常態時才換得準。
假設一次考試成績近似常態分布,平均 45 分、標準差 10 分,某位學生的 Z 值是 +1.96,他大約在什麼位置?
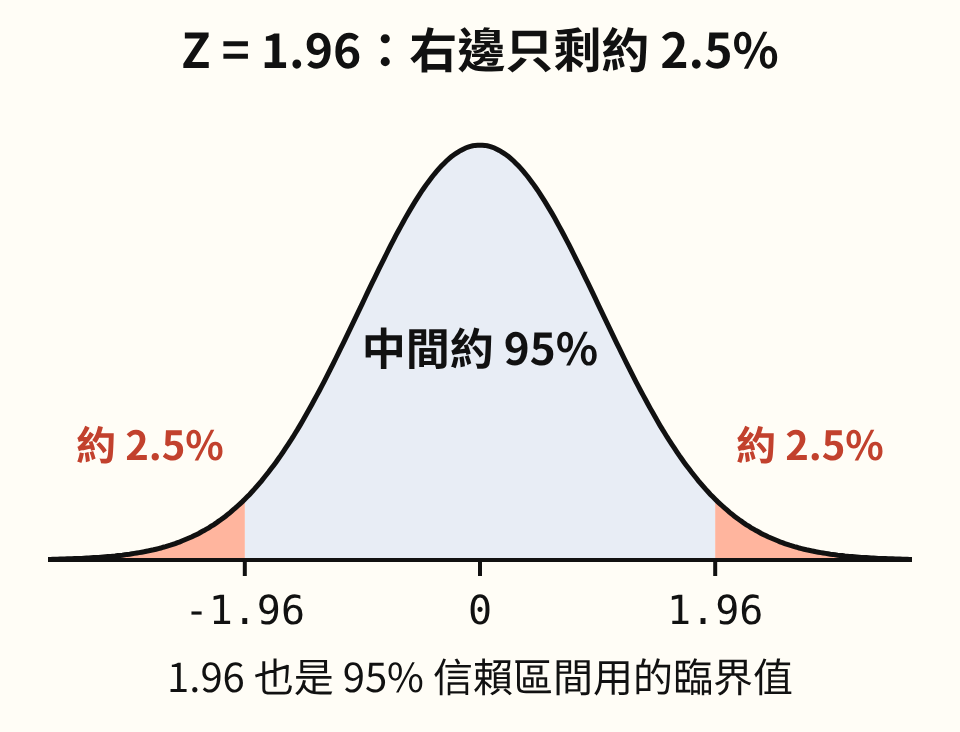
Z 值代表「比平均高幾個標準差」。在標準常態分布中,Z = 1.96 以下的累積機率約 0.975,也就是右邊只剩約 2.5%,所以這位學生大約在前 2.5%。這個數字也是 95% 雙尾區間的臨界值,常和信賴區間一起出現。容易混淆的對照值是:Z ≈ 1.645 對應前 5%,Z ≈ 1 對應前 16% 左右。
四、中央極限定理:樣本平均的分布,和母體的形狀不同
一家門市的營業額可能忽高忽低,但把 50 家門市平均起來,數字就穩定多了:特別高和特別低的會互相抵消。這個「平均起來比較穩、形狀也變得比較對稱」的現象,就是這一組要講的事。
假設要估計連鎖門市的平均單日營業額,母體明顯右偏,少數高流量門市拉高了整體平均。研究員每次隨機抽 50 家門市算一次樣本平均,重複 1,000 次,這 1,000 個樣本平均會呈現什麼形狀?
中央極限定理說的是:只要母體的變異數是有限的,樣本數夠大時,樣本平均的抽樣分布會趨近常態,不管母體本身長什麼樣子。常見的經驗法則是樣本數 30 以上,但這只是參考;母體偏得很嚴重時,可能需要更多樣本。題目最常見的錯誤選項,是說「母體右偏,所以樣本平均也一定右偏」,這是把母體分布和樣本平均的分布混為一談。
五、假設檢定:p 值、兩種錯誤與檢定力
新聞常寫「研究證實某某有效」。這一組要拆開的是:研究到底算出了什麼,「證實」這兩個字又說過頭在哪裡。
假設藥廠檢驗新的降血壓藥,虛無假設 H0 是「新藥與對照組沒有差異」,事前設定顯著水準 α = 0.05,檢定結果 p = 0.03。因為 p 小於事先設定的 α,所以拒絕 H0,表示樣本提供了「有差異」的統計證據。
這題的陷阱在解讀。p 值的意思是:假設 H0 成立時,看到目前這麼極端(或更極端)的結果的機率。它不是「新藥有效的機率」,所以不能說「p = 0.03 代表 97% 有效」。顯著水準也要在看結果之前就決定,不能看到 p = 0.03 之後才改成用 0.01 當門檻。
兩種錯誤可以用醫療影像篩檢來理解。假設 H0 是「沒有結節」:
| 錯誤類型 | 實際狀況 | 判斷結果 | 機率 |
|---|---|---|---|
| 型一錯誤(偽陽性) | 沒有結節(H0 為真) | 判成有結節(拒絕 H0) | α |
| 型二錯誤(偽陰性) | 真的有結節(H0 為假) | 判成正常(沒拒絕 H0) | β |
其中 α 就是事先設定的顯著水準,所以把 α 訂得愈嚴,型一錯誤愈少,但在其他條件不變時,型二錯誤會變多。
檢定力是 1 − β,也就是「效應真的存在時,正確拒絕 H0 的機率」。它會受樣本數、效應大小、資料變異程度與顯著水準影響:樣本數愈多、效應愈明顯,檢定力愈高。所以一項只找到 12 位受試者的研究,即使效果真的存在,也可能因為檢定力不足而檢定不出來。檢定力是設計研究時就要考慮的條件,和事後算出來的 p 值是不同的概念。
六、信賴區間:95% 指的是「方法」,不是這一個區間
選舉前的民調新聞,最後常有一行小字:「在 95% 信心水準下,抽樣誤差為正負 3 個百分點」。這就是信賴區間。
假設一份民調抽樣 1,067 人,某候選人支持率 48%,95% 信賴區間是 45%~51%。這個 95% 該怎麼解讀?
在頻率學派的解讀裡,母體的真實支持率是一個固定、但我們不知道的數字。95% 的意思是:如果用同樣的方法重複抽樣很多次,每次都建一個區間,大約 95% 的區間會涵蓋真實值。至於這一次算出來的 45%~51%,它要嘛涵蓋真值、要嘛沒有,不能說「真實支持率有 95% 的機率落在這裡」。另外兩個常見的錯誤選項是把 95% 說成「95% 的受訪者」,或把信賴區間當成選舉結果的預測。
可以把它想成撒網捕魚:魚(真實值)停在一個固定的位置,每次抽樣就是撒一次網(算出一個區間)。95% 說的是這種撒網方法,大約每 100 次有 95 次會網到魚。不過這個比喻有一點不像:真的撒網,拉起來就知道有沒有魚;信賴區間算出來以後,永遠沒辦法確認這一次有沒有涵蓋真值。
六組怎麼接起來,做題時怎麼用
回到開頭的問題:看到一個統計數字,它說了什麼、沒說什麼?前三組教你看清楚數字在描述什麼,後三組教你判斷從樣本推論出去的結論能信到哪裡。兩半是接起來的:
標準差描述資料散得多開(第二組),Z 值再用標準差把一個數值換成「離平均幾個標準差」的相對位置(第三組)。中央極限定理說明樣本平均的分布會接近常態(第四組),而且樣本愈多,樣本平均散得愈小,這個分散程度叫做標準誤。有了這兩點,檢定和信賴區間才能借用常態分布與 Z 值來計算。
所以 1.96 會同時出現在兩個地方:在第三組,它代表前 2.5% 的位置;在第六組,它是 95% 信賴區間的臨界值。以大樣本的平均數雙尾檢定來說,α = 0.05 的檢定和 95% 信賴區間用的是同一個臨界值,結論也會一致:區間沒有涵蓋 H0 主張的數值,就等於在 α = 0.05 下拒絕 H0。
做題時,可以先從題目的描述判斷它在問哪一類問題:
| 題目出現的描述 | 先判斷什麼 | 對應的概念 |
|---|---|---|
| 少數極端值、要描述「一般」水準 | 平均數會不會被拉走? | 中位數 |
| 長尾往右、薪資或房價 | 分布往哪邊歪?三個量數的大小順序? | 右偏,平均數通常最大 |
| 穩定性、分散程度 | 要看中心,還是看離散? | 標準差、Cp |
| 兩組資料尺度差很多 | 直接比標準差會不會被尺度誤導? | 變異係數 |
| 樣本平均、重複抽樣 | 問的是母體,還是樣本平均的分布? | 中央極限定理 |
| p 值與顯著水準 | p 值是在什麼前提下算出的機率? | 拒絕或不拒絕 H0 |
| 偽陽性、偽陰性 | H0 的實際狀況與判斷結果各是什麼? | 型一錯誤、型二錯誤 |
| 樣本太少、怕檢定不出來 | 效應存在時,抓得到的機率有多高? | 檢定力 |
| 95% 信賴區間 | 95% 描述的是方法,還是這一個區間? | 頻率學派的解讀 |
做錯題時,可以對照這張表檢查自己是哪一步判斷錯:是認錯了題目在問的類型,還是知道類型、卻把結果解讀過頭。統計在中級科目二裡的位置,可以回到〈中級科目二怎麼讀?〉的學習地圖;迴歸報表裡的 p 值怎麼讀,可以接著看〈Python 題看不懂?〉的第五題。
讀完試試看
某份報告寫:「新教材的檢定結果 p = 0.20,大於 0.05,證明新教材沒有效果。」這句話哪裡有問題?
想好再往下看。參考答案:p 值大於顯著水準,只代表「沒有足夠證據拒絕 H0」,不等於證明沒有效果。也可能是樣本太少、檢定力不足,所以就算效果存在也測不出來。
本文情境與數字為自編練習題改寫,非 iPAS 官方試題或教材。正式評鑑範圍與最新規則,請以AI 應用規劃師官方專區公告為準。