如果老師把期末考卷直接拿來當模擬考,班上的模擬考成績會很好看,但這個分數說明不了什麼:大家是真的會了,還是只是先看過題目?想知道學生的真實程度,期末考卷就得留到最後才能打開。
建立預測模型也是一樣。我們會先留下一部分資料當成「期末考卷」,叫做測試資料,等模型訓練完才拿出來,檢查它遇到沒看過的資料時表現如何。如果測試資料提前參與了訓練,最後的分數就像先看過考卷的成績,看起來很好,卻不能代表真正的實力。這種情況叫做資料洩漏。
這篇跟著一個問題走:這個分數,真的代表模型遇到新資料時的表現嗎? 我們會從最直覺的「先看考卷」出發,一步一步推到補值、標準化、交叉驗證和 SMOTE。每一步都只用上一步剛學到的道理。
以下以自編題庫的資料洩漏情境為例,數字都是教學假設,重點在於處理順序。
沒有偷看答案,為什麼也算洩漏?
考卷的比喻有一個地方不像:學生偷看考卷,是直接看到題目和答案。資料洩漏常常沒有碰到答案,只是讓測試資料提前影響了某個計算。先看一個例子。
假設一家公司用量測值建立預測模型。訓練資料中有兩筆有效數值,分別是 10 和 20;另一筆缺值,需要用平均數填補。另有一筆數值 100,已經決定留作測試。
先算算看:如果用全部資料算平均,和只用訓練資料算平均,填補值各是多少?
用全部資料算,填補值會是約 43.33;只用訓練資料的有效數值計算,填補值則是 15。兩個結果不同,是因為測試資料中的 100 已經參與決定訓練資料要填入什麼。
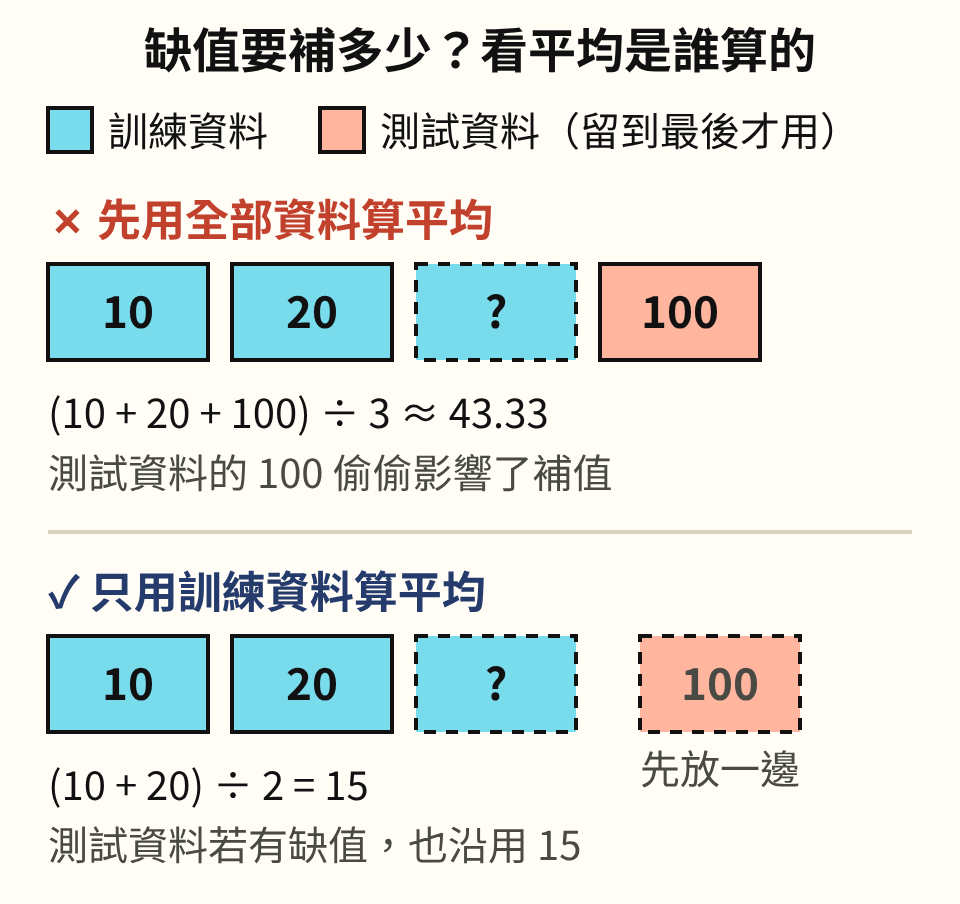
這就像學生沒有看到題目,卻先知道了「這份考卷的平均難度」,於是調整了讀書方式。測試資料裡的 100 沒有被當成答案,卻已經影響了訓練資料長什麼樣子。所以資料洩漏不只是「把答案放進特徵」,也包括讓測試資料參與本來只該由訓練資料決定的步驟。
這一段學到的規則只有一句:凡是要從資料算出來的東西,都只能用訓練資料算。 接下來每一段,都是把這一句用到新的地方。
同一句規則,用在標準化:fit 和 transform
先想想看:標準化要先算出平均數與標準差,才能把數值換成同一套尺度。照上一段的規則,這兩個數字該用哪些資料算?
答案和補值一樣:只用訓練資料。以標準化為例,系統要先從資料估計平均數與標準差,才能把數值轉成同一套尺度。在常見的 scikit-learn 用法中,fit 負責學習這些參數,transform 則依已學到的參數轉換資料。
因此,下面這段流程的問題出在切分時機:
全部資料 → fit 標準化參數 → 轉換全部資料 → 切成訓練集與測試集
到了切分這一步,測試資料已經影響過平均數與標準差。若要保留測試資料的評估角色,流程應改成:
先切分資料
訓練集 → fit 前處理參數 → transform → 訓練模型
測試集 → 沿用訓練集參數 transform → 評估模型
測試集仍需要轉換,因為模型收到的特徵必須使用同一套尺度。需要避免的是再對測試集重新 fit。若兩邊各自學出一套尺度,相同的原始數值可能被轉成不同意思,評估就偏離了原本要驗證的流程。
回頭看上一段的補值,其實就是同一件事:填補值是用訓練資料 fit 出來的,測試資料只是沿用它來 transform。這項原則也可在 scikit-learn 的資料洩漏說明 中核對。
再用一次:交叉驗證的每一輪,都有自己的考卷
現在你已經會判斷「訓練資料和測試資料」這一組。交叉驗證只是把同一件事做好幾次:為了比較模型或挑選參數,交叉驗證會把資料分成幾份,每輪留一份作驗證,其餘用來訓練。這裡的「折」就是其中一份資料。有些題目雖然保留了最終測試集,卻先對剩下的全部資料補值或標準化,再開始交叉驗證;如此一來,各輪的驗證折也已參與前處理參數的估計。
換句話說,每一輪的驗證折都是那一輪的「期末考卷」。因此,每一輪都要重新遵守同一個原則:在當輪訓練折學參數,再套用到當輪驗證折。把前處理和模型放進適當的 Pipeline,並讓交叉驗證執行整條流程,有助於維持這個順序。
Target Encoding 則是用某個類別對應的目標值統計,來取代原本的類別名稱。例如以各地區的平均目標值作為編碼時,如果先拿全部標籤計算,每輪驗證資料的答案就可能提前進入特徵。
訓練資料內部也要留意:若某個類別只出現幾次,直接用這幾筆的答案算編碼,可能讓一列資料的特徵帶入自己的答案。因此需要交叉擬合等安排,讓每一部分的編碼由其他部分的資料估計。保留最終測試集之後,仍要檢查這些內部步驟。
最後一步:SMOTE 不只算數字,還會造資料
前面幾段的前處理,都是從資料「算出幾個數字」:平均數、標準差、編碼值。SMOTE 更進一步,它會產生新的資料。規則還是同一句,只是要守的東西變多了。
當訓練資料中的某種類別太少時,SMOTE 會利用該類別的樣本及其鄰近樣本產生合成資料,增加這一類的訓練樣本。如果先對全部資料執行,再切成訓練集與測試集,後來被分到測試集的資料可能早已參與合成訓練樣本。測試集的類別比例也可能被改變,難以代表原本想評估的情境。
較合適的安排是先保留原始測試資料,再只對訓練集重抽樣。若使用交叉驗證,重抽樣也應在每輪的訓練折內進行。驗證與測試資料保留目標使用情境的分布,才能檢查模型面對這類資料時的表現。
這裡需要辨認前處理工具的功能:標準化是把既有資料轉成另一套尺度;SMOTE 則會改變訓練樣本。兩者都需要守住資料邊界,但不能把它們當成完全相同的轉換。實作時也應使用支援重抽樣的流程工具。
用一題檢查自己是否理解
某團隊先保留最終測試集,接著把剩餘資料全部標準化,再用交叉驗證挑選模型參數。工程師說:「最終測試集完全沒用到,所以每輪驗證一定沒有洩漏。」這個說法哪裡需要修正?
問題在於每輪驗證折已參與剩餘資料的標準化參數估計。應讓前處理跟著每輪切分,在當輪訓練折 fit,再對驗證折 transform。保留最終測試集是必要安排,但還要檢查模型選擇過程內部的資料使用方式。
回頭看整條路:從「期末考卷不能先看」,推出補值只能用訓練資料;同一句規則用到標準化,就是 fit 和 transform 的分工;再用到交叉驗證,變成每一輪都要分開處理;最後連會產生新資料的 SMOTE,也要守同一條界線。
下次遇到補值、標準化或重抽樣題,可以在題目旁寫下三件事:哪份資料是這一輪的「考卷」、哪一步會從資料學參數或產生樣本,以及這一步是否只用了當時的訓練資料。這樣就能回答開頭的問題:這個分數,是否真的在衡量模型面對未見資料時的表現?
想再練習程式判讀,可接著閱讀 Python 題的拆解方式,或回到 中級自學路線 安排複習。
本文練習情境由自編題庫改寫,非 iPAS 官方試題或教材。正式評鑑範圍與考試規則,請以 AI 應用規劃師官方專區 公告為準。