準備中級科目三「機器學習技術與應用」時,很多人看到貝氏定理、矩陣分解、特徵值、學習率,就以為要把大學數學整套重讀。實際做題時,題目很少要你從頭推導公式,比較常見的是給一個情境,問你「這時該用哪個工具」或「這個結果該怎麼解讀」。
這篇把我整理的 10 道模擬題情境,依觀念分成六組,每組說明題目在問什麼、怎麼判斷,以及最常見的陷阱。題目情境與數字為自編練習,用來說明判斷方法,不是官方試題。
這六組背後是機器學習用到的三塊數學,各自回答一個問題。機率回答「資訊不完整時怎麼推論」(第一組);線性代數回答「大量資料怎麼表示、怎麼壓縮」(第二、三組);微積分與優化回答「模型怎麼一步一步學」(第四到六組)。讀到不熟的名詞時,先判斷它屬於哪一塊,就知道題目大概在問哪一類問題。
這三塊數學,其實你在生活裡都碰過:看到快篩兩條線時的猶豫,是機率;替一個東西找最好認的拍照角度,是線性代數;在霧裡摸著坡度下山,是優化。每一組都會先從這些經驗講起,再換成考題的情境。
一、貝氏定理:陽性不等於患病,先看基本比例
疫情那幾年,很多人都有過快篩出現兩條線、心裡一沉的經驗。兩條線,就代表一定生病了嗎?這個問題的答案,取決於一個很多人會忽略的數字。
假設某種疾病在就診族群中的盛行率是 1%,快篩的敏感度(真的患病時驗出陽性的比例)是 95%,特異度(沒患病時驗出陰性的比例)也是 95%。一位民眾驗出陽性,他真的患病的機率大約多少?
往下看之前,先猜一個數字。
很多人會猜 95%,但這是把「患病時驗出陽性」和「驗出陽性時真的患病」搞混了。把比例換成人數會比較好懂,假設有 10,000 人來篩檢:
| 族群 | 人數 | 驗出陽性 |
|---|---|---|
| 真的患病 | 100 | 95(敏感度 95%) |
| 沒有患病 | 9,900 | 495(特異度 95%,另外 5% 被誤判) |
| 合計 | 10,000 | 590 |
驗出陽性的 590 人裡,真的患病的只有 95 人,所以機率是 95 ÷ 590,約 16.1%。畫成點陣圖,就看得出原因:
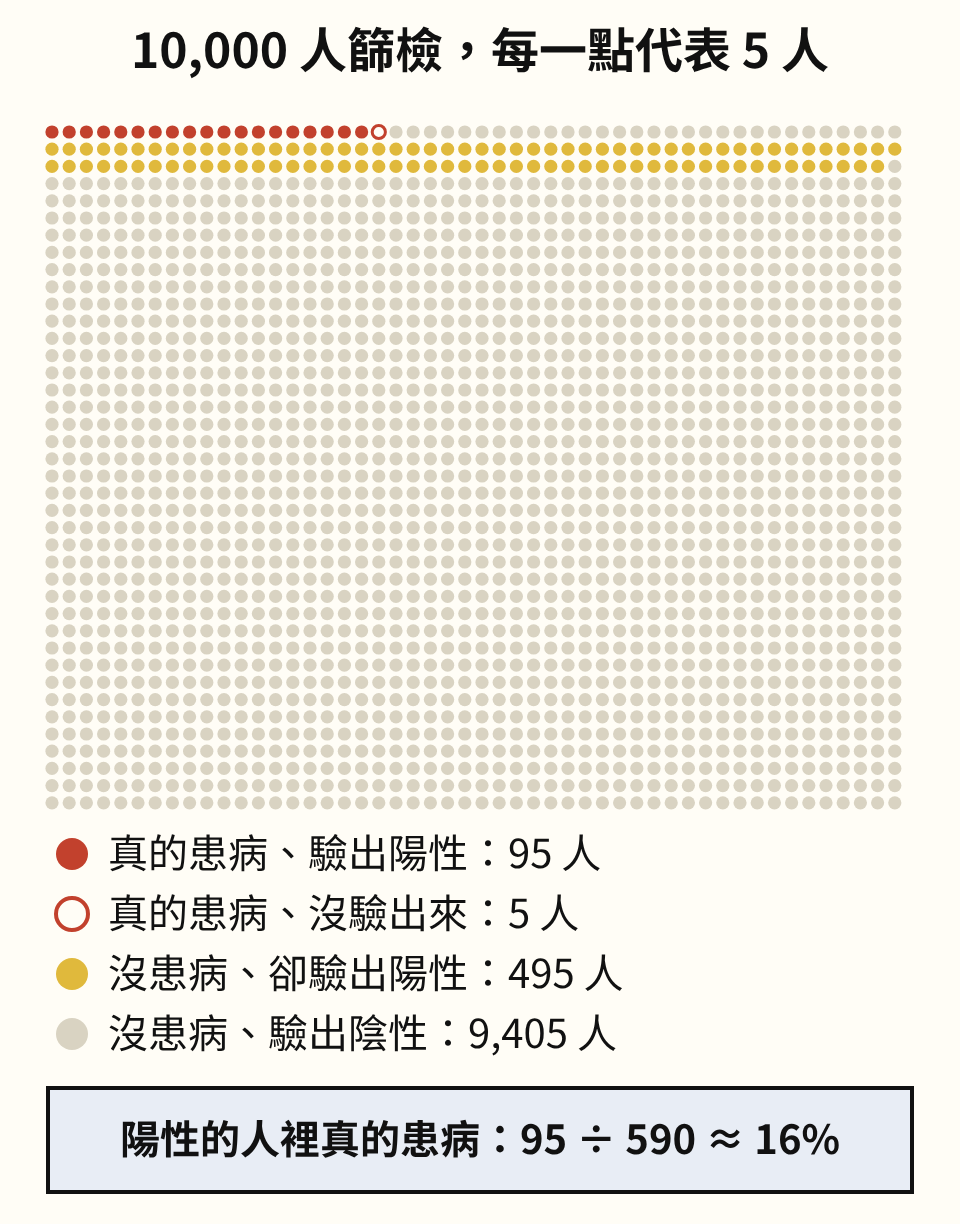
紅點和黃點都是「驗出陽性」,黃點的數量卻是紅點的五倍多。疾病本身很少見時,沒患病的人數太多,就算只有 5% 被誤判,誤判的人數仍然遠多於真的患病的人。題目出現「盛行率很低」、「陽性後真正患病的機率」,就是在考這個觀念。
同一套機率想法延伸到分類模型,就是 Naive Bayes。假設要用郵件裡的關鍵字判斷是不是垃圾信,Naive Bayes 假設:在已知「是垃圾信」的前提下,每個關鍵字出現與否彼此獨立,這樣就能把很多特徵的機率分開估計再相乘,計算量小很多。現實中「免費」和「中獎」常常一起出現,這個假設並不成立,但實務上分類結果常常仍然不錯。常見的錯誤選項有三種:說它「沒有獨立假設」(獨立假設正是它名字裡 Naive 的由來)、說它「只能處理類別特徵」(Gaussian Naive Bayes 可以直接處理連續數值),或說它「只能做二元分類」(它本來就能處理多個類別)。
二、SVD 與 PCA:把大矩陣壓小,同時留下最重要的方向
假設一個電商有 500 萬名用戶、200 萬件商品,評分表大部分是空的。想把這張大表壓縮成「用戶的潛在偏好」和「商品的潛在屬性」兩組比較短的向量,該用哪種矩陣分解?
答案是 SVD(奇異值分解)。它可以把任何形狀的矩陣拆成 U、Σ、V 三個部分,只保留前 k 個最大的奇異值,就能得到原矩陣在 k 個維度下的最佳近似。U 的每一列可以看成一位用戶的潛在向量,V 的每一列則對應一件商品。其他選項各有用途,但不適合這個問題:QR 分解主要用來解線性方程組,Cholesky 分解只能用在對稱正定的矩陣上,評分表通常連方陣都不是。
這裡補一個實務上的差別:真正的推薦系統,評分表大多是空格,不會直接把空格當成 0 套用標準 SVD,而是只用「已知的評分」去學出兩組向量,這種做法常被稱為矩陣分解。考題問的是「哪種線性代數分解最適合做低秩近似」,所以選 SVD;知道兩者的差別,遇到題目換個問法時才不會被混淆。
和 SVD 關係密切的是 PCA(主成分分析)。
先想想拍照:要替一隻長頸鹿拍一張平面照片,從側面拍,一眼就認得出來;從正上方往下拍,只看得到一團斑點。照片少了一個維度,但選對角度,留下的資訊就多很多。PCA 做的是同一件事,只是資料可能有幾百個欄位,「最好認的角度」也不是用眼睛挑,而是用數學算出來。
換成資料的說法:如果要你把很多欄位縮成兩三個,又要盡量不丟資訊,你會怎麼做?直覺的做法是找資料散得最開的方向。散得愈開,代表資料在這個方向上的差異愈大,留下這個方向,就留下了最能區分資料的資訊。
PCA 就是用數學把這些方向找出來:資料先中心化後算出共變異數矩陣,再求它的特徵值與特徵向量:
- 特徵向量是方向,代表資料可以沿著哪些方向展開。
- 特徵值是那個方向上的變異量,數值愈大,代表資料在這個方向上散得愈開、保留的資訊愈多。
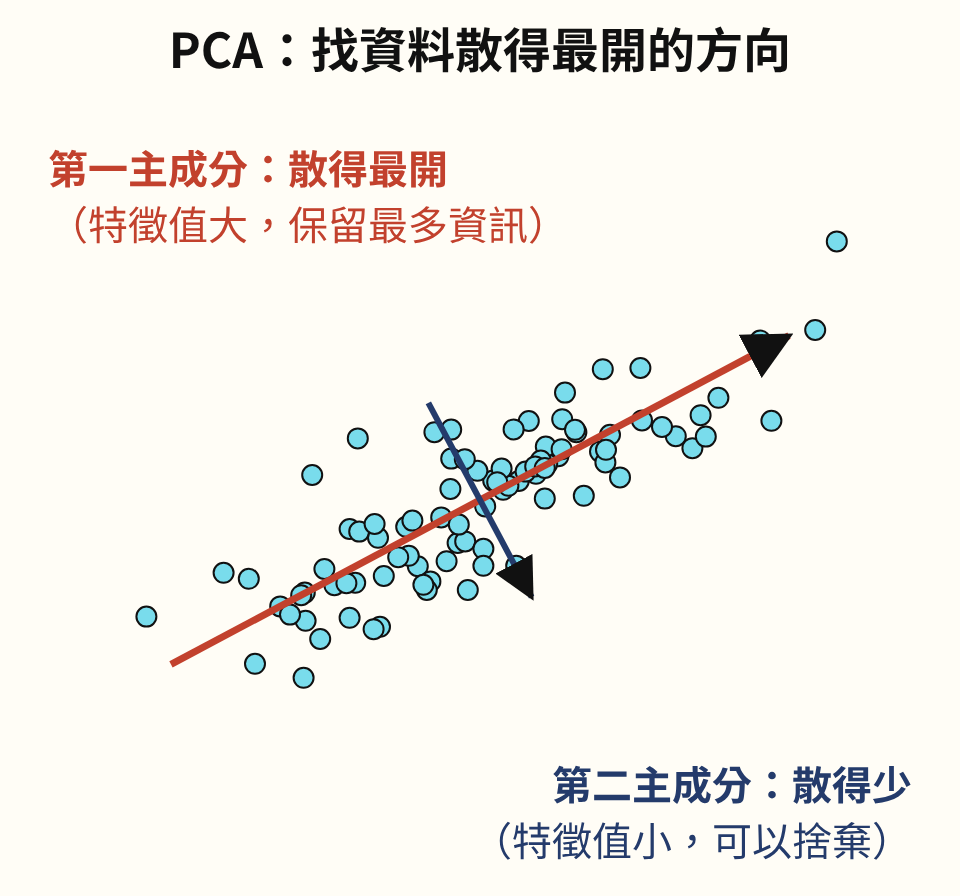
所以 PCA 要選特徵值最大的 k 個方向,不是最小的。共變異數矩陣是對稱、半正定的,特徵值不會是負數,不同特徵值對應的特徵向量也互相垂直。題目如果說「特徵值為負代表資訊反向」,或說「主成分彼此高度相關,要再做處理才能獨立」,都是錯誤選項。
三、共線性:兩個欄位講同一件事,矩陣就算不出來
假設做線性迴歸時,資料裡同時有「身高(公分)」和「身高(公尺)」兩個欄位。這兩欄只差一個固定倍數,叫做完全共線。
最小平方法的公式解需要算 (X^T X) 的反矩陣。兩欄完全共線時,這個矩陣是「奇異矩陣」,反矩陣不存在,係數就沒辦法得到唯一的答案。處理方式有兩種:直接刪掉重複的欄位,或改用 Ridge 迴歸(L2 正則化),在矩陣的對角線加上一個正數 λ,公式解變成:
(X^T X + λI)^(-1) X^T y
只要 λ 大於 0,括號裡的矩陣就一定可逆。
要注意,共線性影響的是所有相關係數的估計,不只是截距。另外,很多程式套件遇到這種情況不會直接報錯,而是改用其他方法算出一組係數,但這組係數不是唯一的,解讀時仍然會出問題。題目若說「完全共線不影響求解」,或「直接改用深度學習就好」,都沒有處理到資料本身的問題。
四、學習率與批次大小:訓練不穩,先看更新的步伐
假設一個五層的神經網路做房價預測,loss 一開始下降很快,接著開始大幅震盪,最後變成 NaN(數值溢位、算不出來)。檢查設定發現學習率是 1.0。
學習率決定每次更新參數時跨多大一步。步伐太大,就會在最低點附近來回跳過頭,甚至愈跳愈遠。最直接的處理是降低學習率(例如先試 0.01 或 0.001),再搭配學習率衰減,讓訓練前期步伐大一點、後期小一點,方便收斂。加大批次、把網路加深、拿掉正則化,都沒有處理到「步伐太大」這個原因。
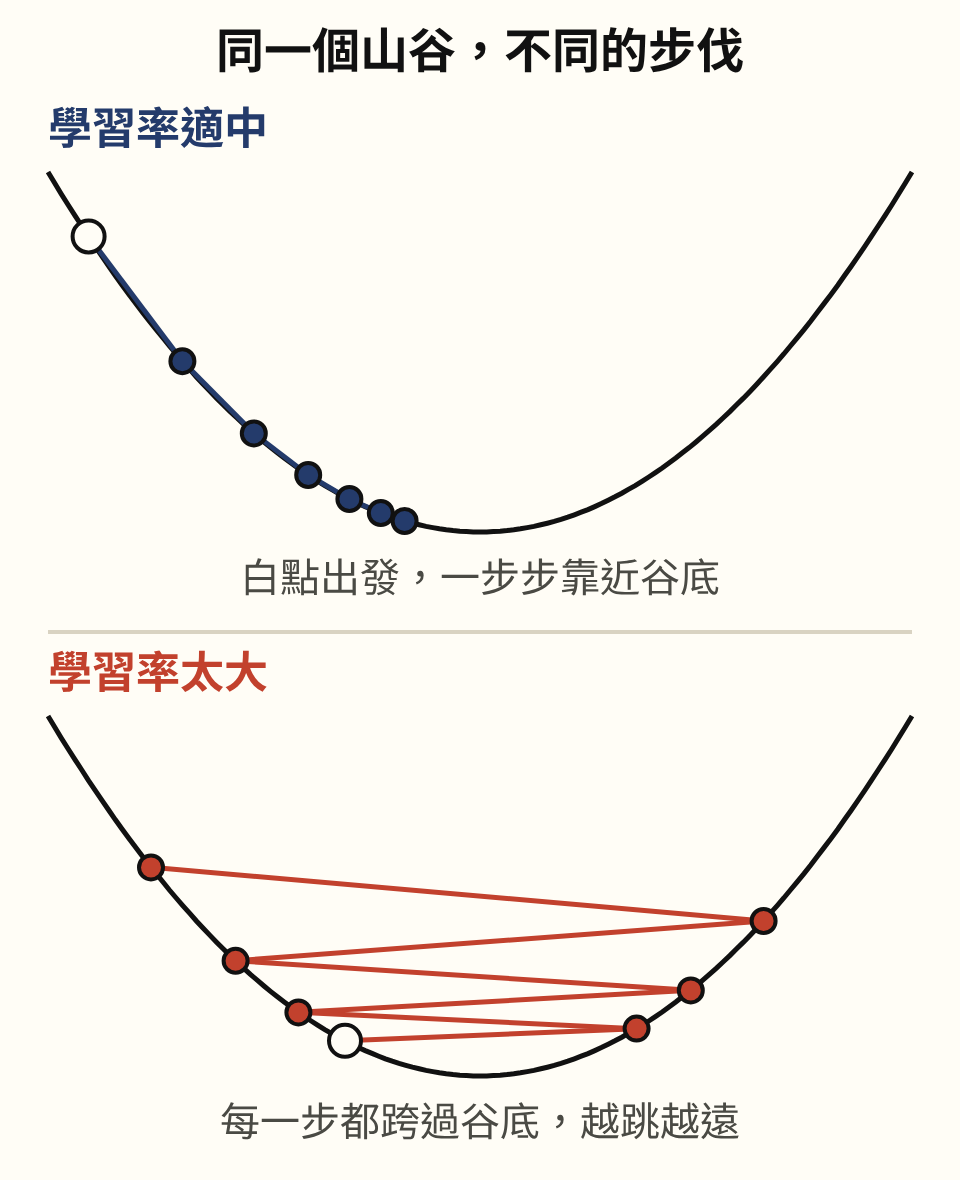
可以把訓練想成在濃霧裡下山:看不到整座山,只能摸腳下的坡度(梯度)往低處走,學習率就是每一步跨多大。這個比喻有一點不像:真的山只有前後左右幾個方向,模型的參數卻可能有上百萬個方向,所以下一節的「鞍點」,在模型裡比在真的山上常見得多。
反過來的情況也常考。假設把批次大小從 32 加大到 256,訓練變得不穩定、準確率下降。批次變大後,每個 epoch 的更新次數變少,梯度估計也比較穩定,所以常見的做法是讓學習率跟著放大:
- 線性縮放:批次放大幾倍,學習率就放大幾倍,從 32 到 256 是 8 倍。
- 平方根縮放:學習率放大為批次倍數的平方根,常搭配 Adam 這類優化器使用。
- Warmup(暖身):訓練最初幾個 epoch 先用較小的學習率,再逐步升到目標值,避免一開始就發散。
這些都是經驗法則,不是保證有效的公式。批次大到一定程度後,單純放大學習率也會失效。題目若說「批次改變時學習率應保持不變」,或「批次變大要把學習率縮小」,方向就錯了。
五、優化地形:卡住的地方,通常是鞍點
延續下山的比喻:上一節講的是步伐太大,這一節換成地形本身。下山時最麻煩的不是陡坡,而是一大片幾乎平坦的地方,腳下摸不出往哪邊比較低,只能慢慢試。
深度學習的 loss 地形不是一個單純的碗,而是高低起伏、很多維度的曲面。其中常讓訓練卡住的是鞍點:在某些方向是最低點,在另一些方向卻是最高點,就像馬鞍的中央。在鞍點附近梯度很小,單純的 SGD 會走得很慢,甚至在附近來回震盪。
常見的解法是換優化器:
- Momentum(動量):累積過去的梯度方向,讓更新帶有慣性,比較容易衝過平坦的區域。
- RMSProp、Adam:除了動量,還會追蹤「梯度平方」的移動平均,依此替每個參數調整學習率。這種做法常被稱為二階動量,指的是梯度平方的平均,不是二次微分。
關於地形本身,研究上常見的觀察是:在很高維度的參數空間裡,鞍點比真正的局部最小值常見得多;而實際訓練到的局部最小值,表現常常和全域最小值相差不大。這是經驗上的觀察,不是保證。題目常見的錯誤選項包括:「深度網路的 loss 是凸函數,一定收斂到全域最小」、「學習率夠大就保證跳出局部最小」,以及「局部最小通常優於全域最小」。
六、梯度爆炸與梯度消失:兩個問題,兩種處理
再往下走一步:下山時,坡度是你自己用腳摸到的。深層網路沒那麼直接,最後一層算出的「該往哪邊走」,要一層一層傳回前面的層,有點像傳話遊戲。一句話經過很多人轉述,可能越傳越誇張,也可能越傳越小聲,最後前面的人根本聽不到。這個比喻不像的地方是:傳話是內容走樣,梯度是數值被一層層乘大或乘小,方向本身不一定錯。
假設用很深的 RNN 處理長篇文字,訓練時 loss 忽高忽低,有些時候參數突然大幅跳動,有些時候又幾乎不動。這是梯度爆炸和梯度消失同時出現。
梯度在很多層之間往回傳時,會一層一層地相乘。如果每一層的倍數都大於 1,乘到最後就變得非常大,叫做梯度爆炸;如果每一層都小於 1,乘到最後就趨近 0,前面的層幾乎學不到東西,叫做梯度消失。兩個問題的處理方式不同:
| 問題 | 會看到的現象 | 常見處理 |
|---|---|---|
| 梯度爆炸 | 參數突然大幅跳動、出現 NaN | Gradient Clipping(梯度截斷):梯度超過上限就截斷 |
| 梯度消失 | 前面的層幾乎不更新、學不到長距離關係 | 改用 LSTM、GRU 的門控機制,或加入殘差連接 |
增加訓練次數、把批次加到很大,都沒有處理到梯度在層與層之間被放大或縮小的原因;直接放棄序列模型,則等於不處理原本的任務。
三塊數學怎麼接起來,做題時怎麼用
有幾組觀念在題目裡常被放在一起,容易混淆:
- SVD 與 PCA:PCA 可以直接用 SVD 來算,把中心化後的資料做 SVD,得到的方向就是主成分。兩者的差別在用途:SVD 是通用的矩陣分解,PCA 是用它來找變異最大的方向。
- 正則化:第三組的 Ridge 是正則化的一種,第四組錯誤選項裡「拿掉正則化」,拿掉的就是這類限制。正則化處理的是過擬合或矩陣不可逆,不是學習率太大造成的震盪。
- 第四到六組其實是同一件事:模型每次更新參數,大致是「沿著梯度的反方向,走學習率那麼大的一步」。學習率太大是步伐出了問題(第四組);卡在鞍點是梯度太小、方向不明(第五組);梯度爆炸或消失,是梯度在層與層之間被放大或縮小(第六組)。判斷時先問:出問題的是步伐,還是梯度本身?
做題時,可以先從題目的描述判斷它在問哪一類問題:
| 題目出現的描述 | 先判斷什麼 | 對應的概念 |
|---|---|---|
| 盛行率低、陽性後真正患病的機率 | 問的是「患病時陽性」,還是「陽性時患病」? | 貝氏定理 |
| 關鍵字分類、特徵很多 | 這個模型假設了什麼?假設不成立還能用嗎? | Naive Bayes |
| 大矩陣壓縮、用戶與商品的潛在向量 | 要拆解的是什麼形狀的矩陣? | SVD |
| 降維、主成分 | 特徵值和特徵向量各代表什麼? | PCA |
| 欄位重複、矩陣不可逆 | 有沒有兩欄在講同一件事? | 共線性、Ridge |
| loss 震盪、出現 NaN | 每一步的更新是不是太大? | 降低學習率 |
| 批次變大後訓練變差 | 學習率有沒有跟著調整? | 學習率縮放 |
| 訓練卡住、梯度很小 | 卡在局部最小,還是鞍點? | 動量類優化器 |
| 深層或長序列、梯度忽大忽小 | 是爆炸、消失,還是兩者都有? | 梯度截斷、LSTM |
做錯題時,可以對照這張表檢查自己是哪一步判斷錯:是認錯了題目在問的類型,還是知道類型、卻把結果解讀過頭。快篩的例子和假設檢定的「偽陽性」是同一件事,可以對照〈機率統計題怎麼判斷?〉的型一、型二錯誤;還在比較科目二和科目三,可以回到中級科目選擇。
讀完試試看
某模型訓練時,loss 很快就變成 NaN。同事建議:「把批次加大就好。」你會怎麼回應?
想好再往下看。參考答案:先檢查學習率是不是太大。NaN 常來自更新的步伐過大、數值越跳越遠。加大批次只會讓梯度估計比較穩定,沒有縮小步伐;照線性縮放的習慣,批次變大時學習率還會跟著放大。如果是很深的網路或 RNN,也要檢查是不是梯度爆炸,可以用梯度截斷處理。
本文情境與數字為自編練習題改寫,非 iPAS 官方試題或教材。正式評鑑範圍與最新規則,請以AI 應用規劃師官方專區公告為準。